Exercice 6 — Activer la HA et survivre à une panne
Durée : ~45 min · En équipe · Théorie associée : Migration à chaud et haute disponibilité
Le mandat
La direction d'Aria Airlines a classé ses services. La vente en ligne, l'enregistrement à l'aéroport et la base de données qui les alimente sont critiques : chaque minute d'arrêt coûte des billets ou retarde un avion. Le portail de formation ne l'est pas : si une formatrice doit reporter son cours d'une demi-journée, la compagnie ne perd rien.
Vous allez protéger les trois services critiques par la haute disponibilité, laisser le portail de formation sans protection, puis couper le courant du serveur qui les porte tous.
Objectif
aria-db, aria-web et aria-staff redémarrent d'eux-mêmes sur un autre nœud après la panne brutale de leur serveur. aria-formation reste arrêtée jusqu'à ce qu'un administrateur intervienne.
Prérequis
- L'exercice 5 terminé : les quatre VM tournent sur le serveur 2, et les serveurs 1 et 3 sont vides.
- L'accès à l'iDRAC du serveur 2, comme à la semaine 2.
Étape 1 — Lire l'état de la HA
Sélectionnez Datacenter, puis HA.
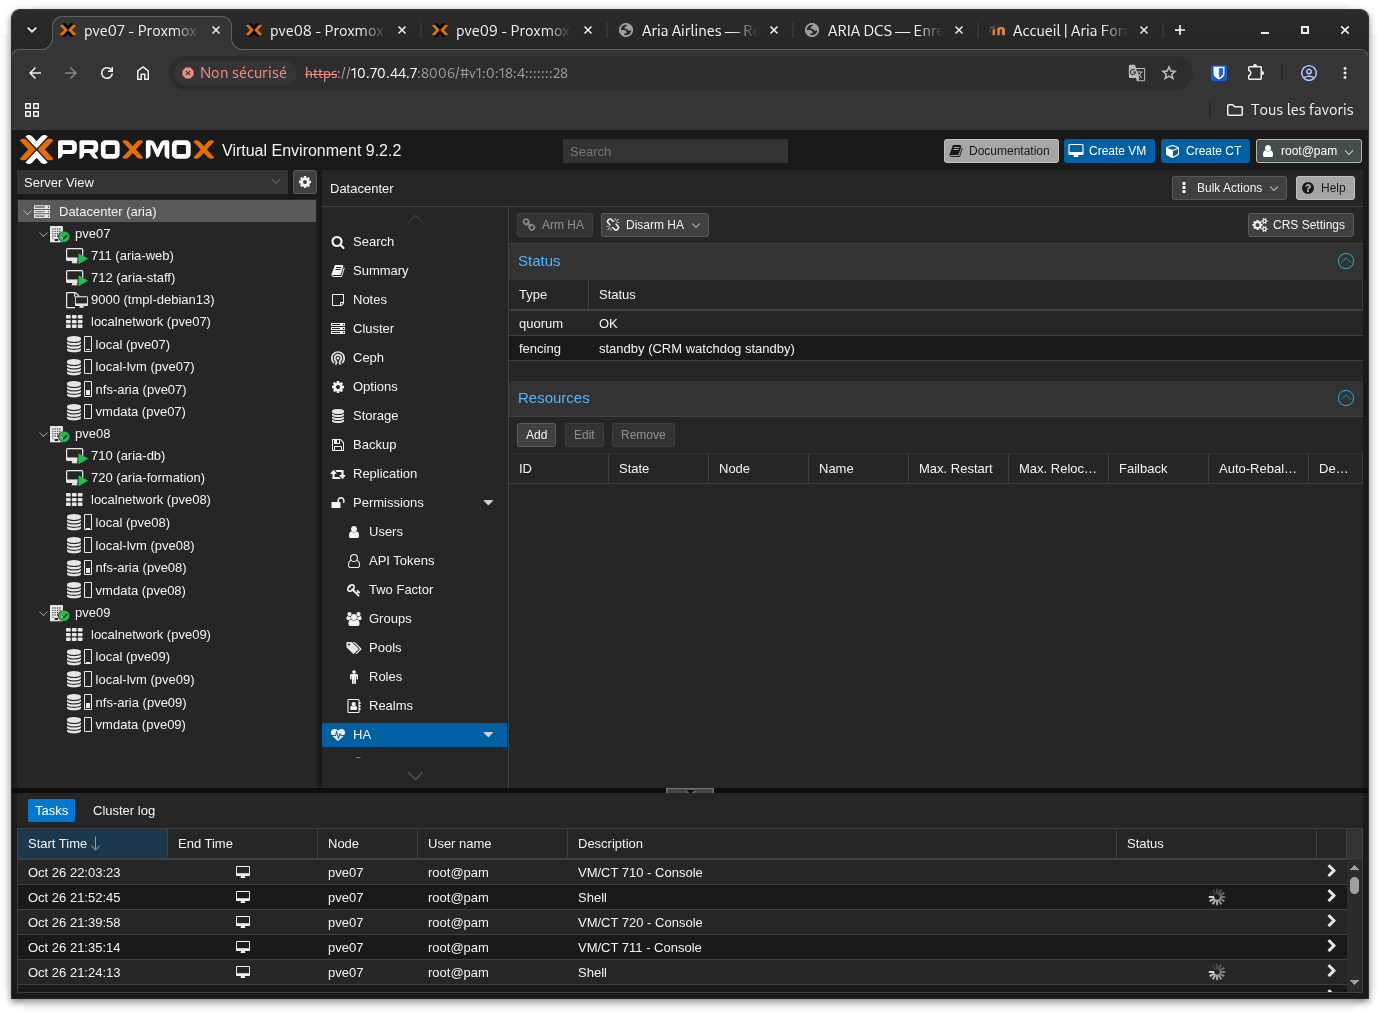
Le panneau Status affiche quorum OK, puis une ligne par nœud. Aucune ressource n'est encore déclarée : le gestionnaire de HA est en place sur chaque nœud, mais n'a rien à surveiller.
Étape 2 — Déclarer les trois ressources critiques
Dans le panneau Resources, cliquez sur Add. Remplissez la fenêtre avec la première ligne du tableau, cliquez sur Add, et recommencez pour chaque ligne. Laissez les autres champs à leur valeur par défaut.
| VM | Request State |
|---|---|
710 |
started |
711 |
started |
712 |
started |
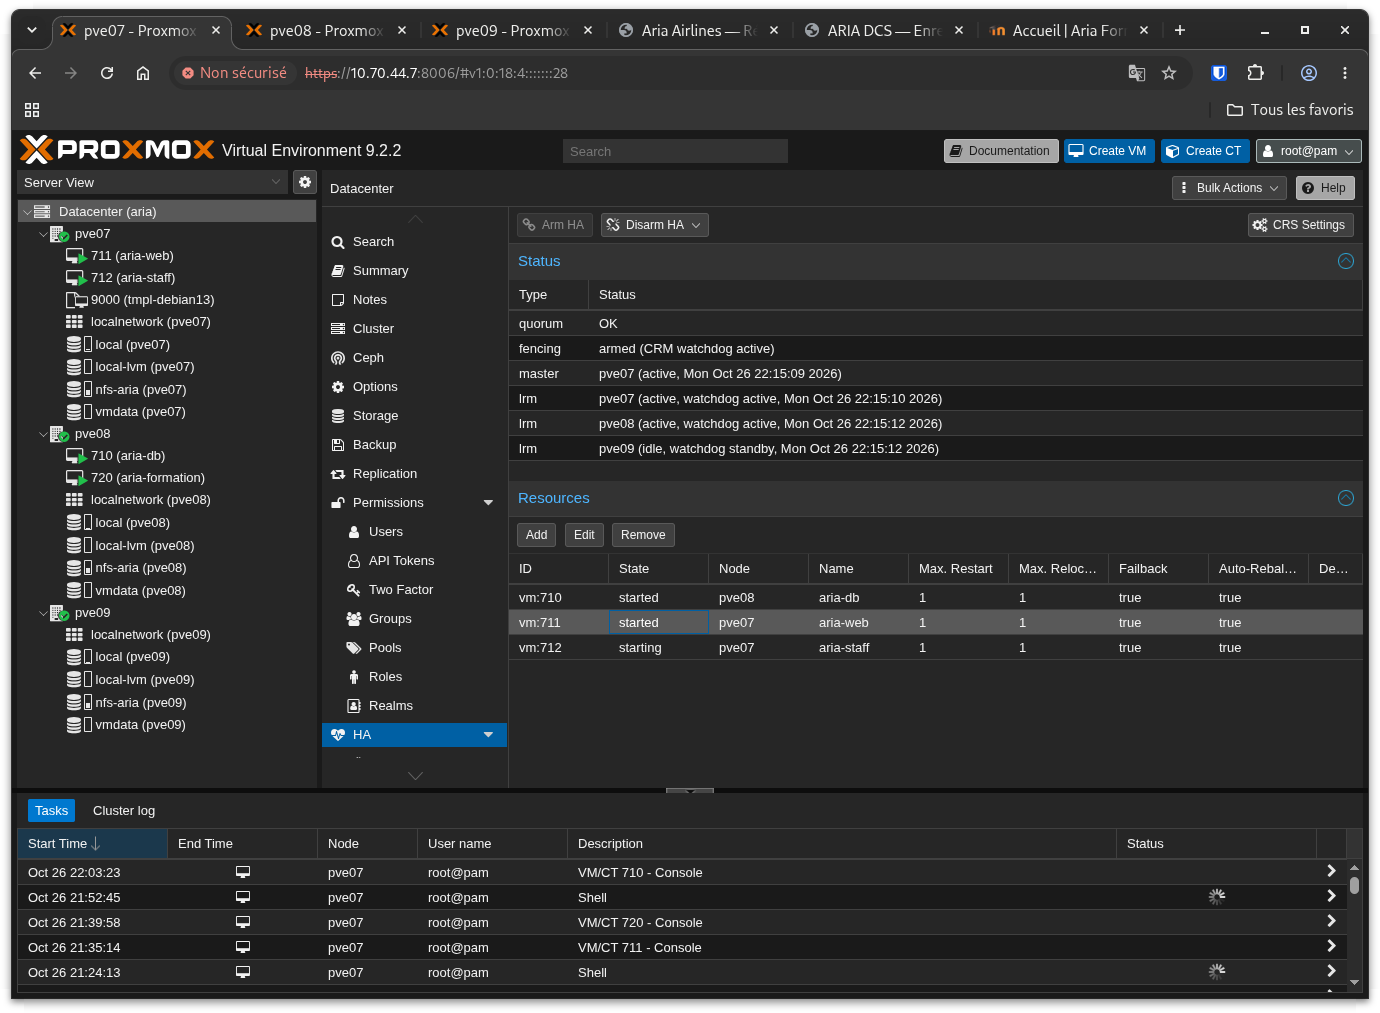
N'ajoutez pas la VM 720. C'est le choix de la direction des TI: le portail de formation ne justifie pas de réserver de la mémoire sur chaque nœud, jour et nuit, pour l'accueillir en cas de panne.
Étape 3 — Vérifier les ressources en ligne de commande
Ouvrez le Shell du serveur 1.
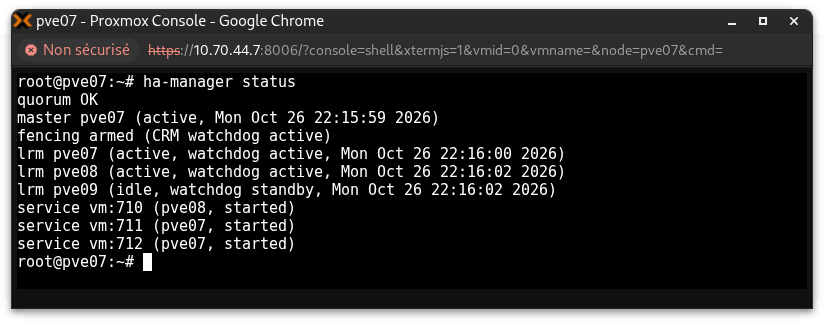
Lisez les lignes de haut en bas. master désigne le nœud qui prend les décisions pour tout le cluster. fencing armed indique que le chien de garde est armé : un nœud qui perd le contact avec les autres s'éteindra de lui-même. Les lignes lrm donnent l'état de l'exécutant de chaque nœud. Les lignes service listent les ressources : vm:710, vm:711 et vm:712, toutes started, toutes sur le serveur 2. La VM 720 n'y est pas.
Étape 4 — Éteindre aria-web de l'intérieur
Ouvrez la console de aria-web, connectez-vous, et éteignez la VM.
Regardez l'arborescence. La VM s'arrête, puis redémarre d'elle-même dans les secondes qui suivent.
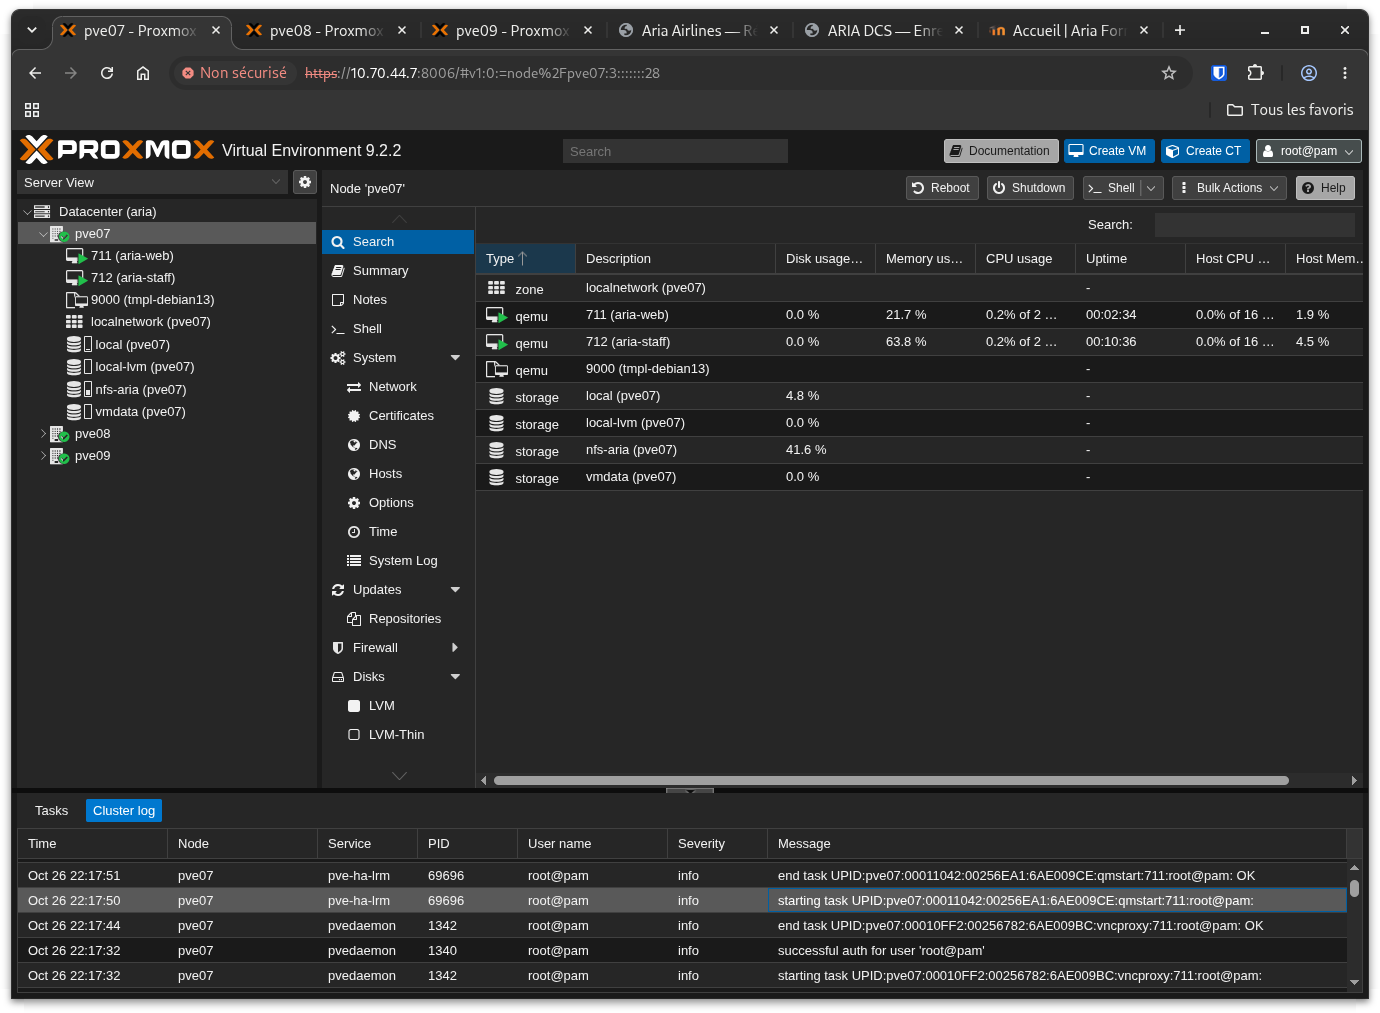
L'état demandé de vm:711 est started. La HA a vu une ressource arrêtée qui devait tourner, et l'a redémarrée. Pour arrêter volontairement une ressource HA, il faut passer son état demandé à stopped ; un simple Shutdown ne suffit pas.
Étape 5 — Lancer la surveillance du site
Dans le Shell du serveur 1, lancez cette boucle. Elle interroge le site toutes les cinq secondes et affiche l'heure suivie du code HTTP.
while true; do echo "$(date +%T) $(curl -s -m 2 -o /dev/null -w '%{http_code}' http://10.70.8E.11/sante)"; sleep 5; done
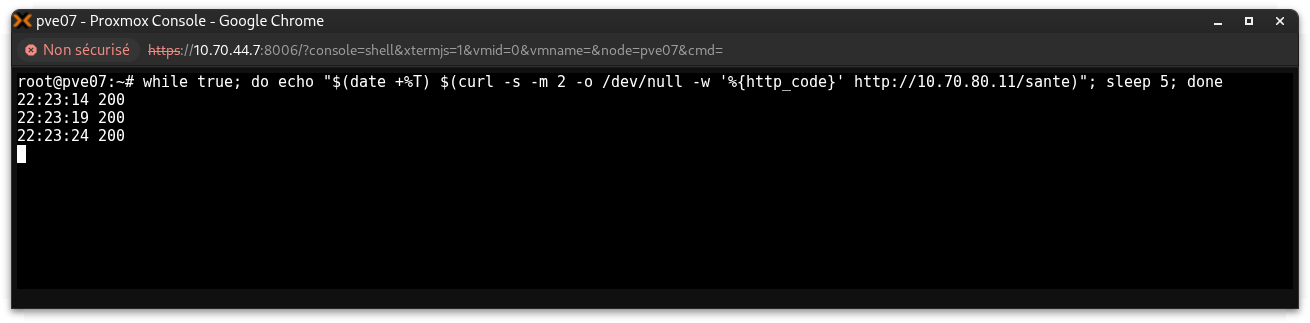
200 : le site répond. 000 : personne ne répond. Laissez la boucle tourner jusqu'à l'étape 10.
Étape 6 — Ouvrir le site et le comptoir
Sur votre poste, ouvrez http://10.70.8E.11 dans un onglet et http://10.70.8E.12 dans un autre. Gardez-les ouverts.
Étape 7 — Couper le courant du serveur 2
Vérifiez deux fois le numéro du serveur
Vous coupez l'alimentation d'un serveur sans arrêter son système. Sur le bon serveur, c'est l'exercice. Sur celui d'une autre équipe, c'est leur travail qui disparaît.
Ouvrez l'interface de l'iDRAC du serveur 2. Dans les contrôles d'alimentation du tableau de bord, choisissez Power Off System / Mettre hors tension le système, et confirmez. Notez l'heure exacte.
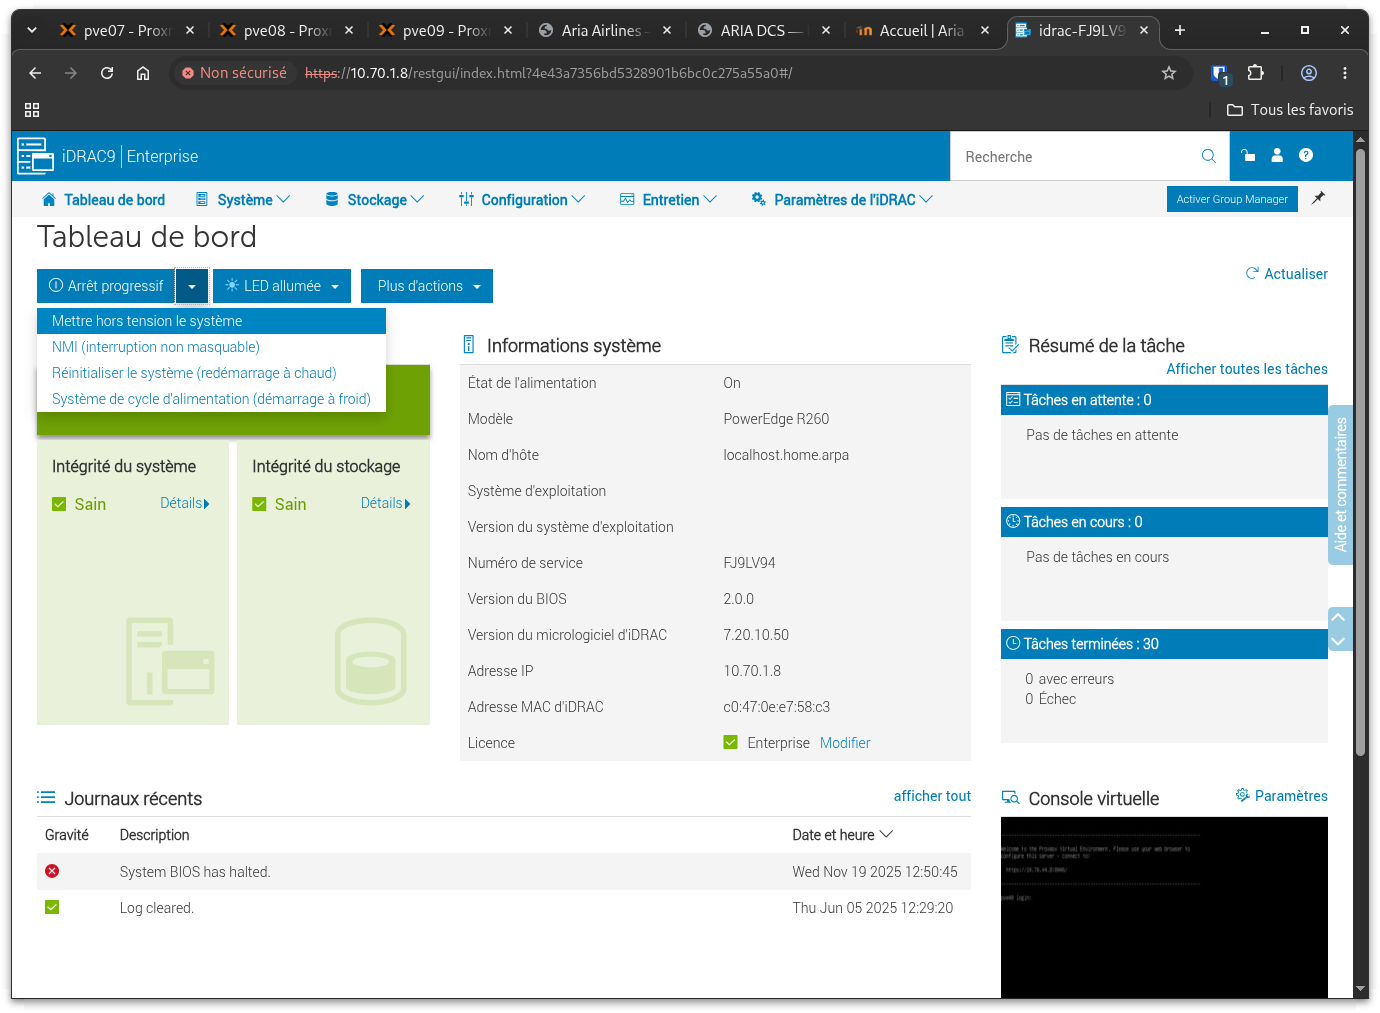
N'utilisez ni Power Cycle System (cold boot) ni Reset System (warm boot) : le serveur redémarrerait aussitôt, alors qu'il doit rester éteint jusqu'à l'étape 14. N'utilisez pas non plus Graceful Shutdown. Un arrêt propre préviendrait Proxmox, qui appliquerait sa politique d'arrêt. Vous voulez au contraire une vraie panne : le serveur s'éteint comme si son alimentation avait grillé.
Étape 8 — Observer la perte du nœud
Revenez dans l'interface web, sur le serveur 1 ou le serveur 3. Rafraîchissez Datacenter > HA.
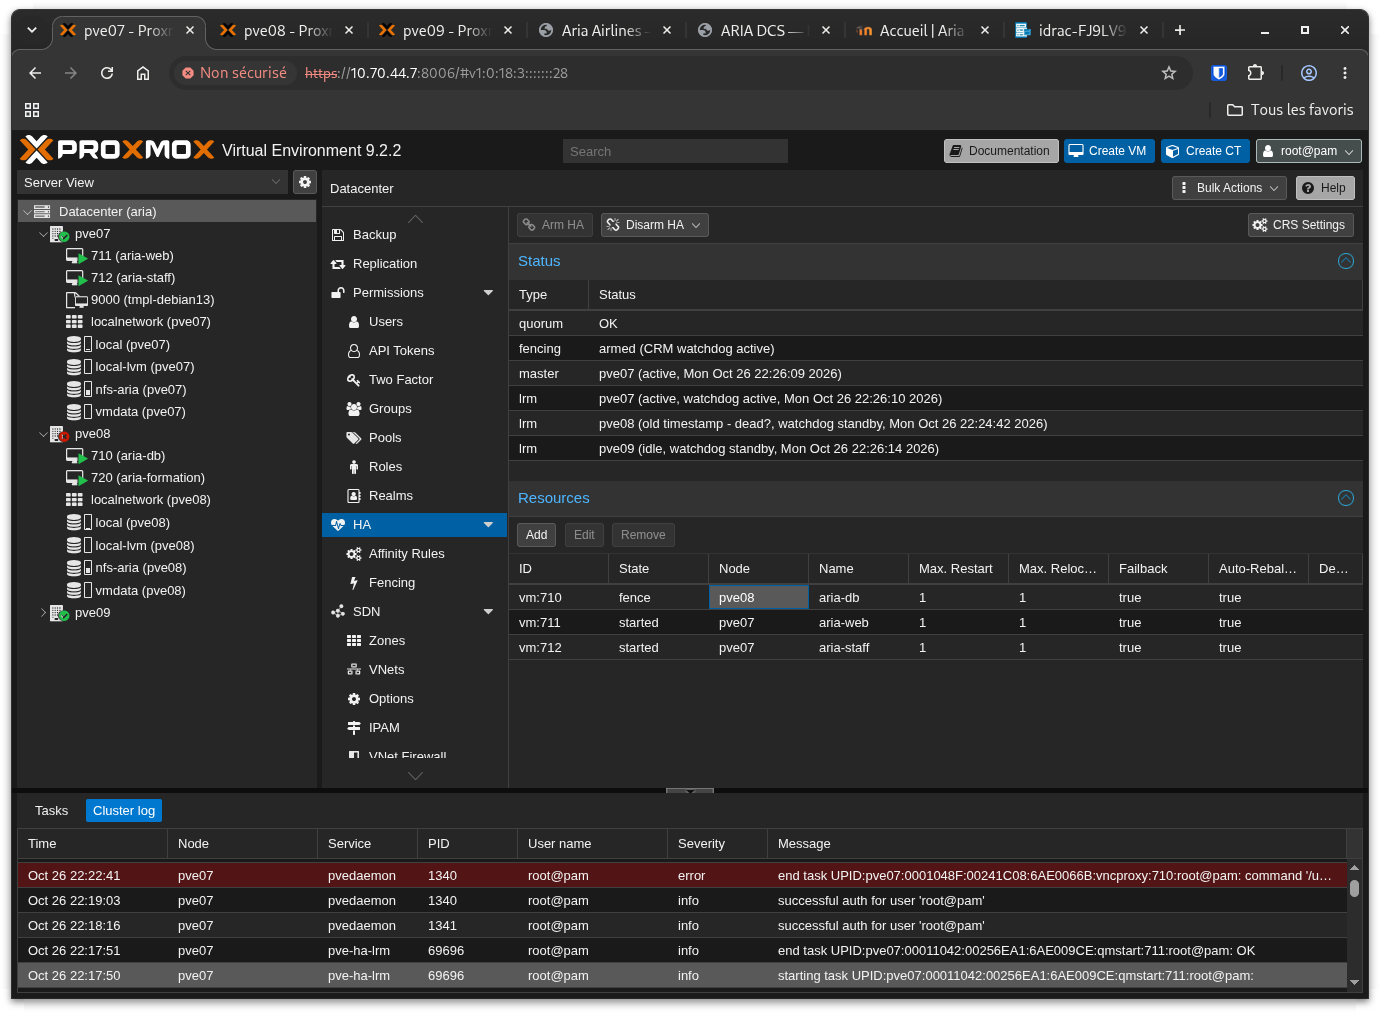
Le serveur 2 apparaît en rouge dans l'arborescence, au bout d'une trentaine de secondes. Ses quatre VM sont grisées. Les trois ressources HA passent à l'état fence : le cluster attend d'être certain que le serveur 2 ne touche plus aux disques avant de redémarrer quoi que ce soit.
Pendant ce temps, vos deux onglets affichent une erreur. Le site est arrêté, le comptoir aussi.
Étape 9 — Attendre la reprise
Rafraîchissez Datacenter > HA toutes les trente secondes.
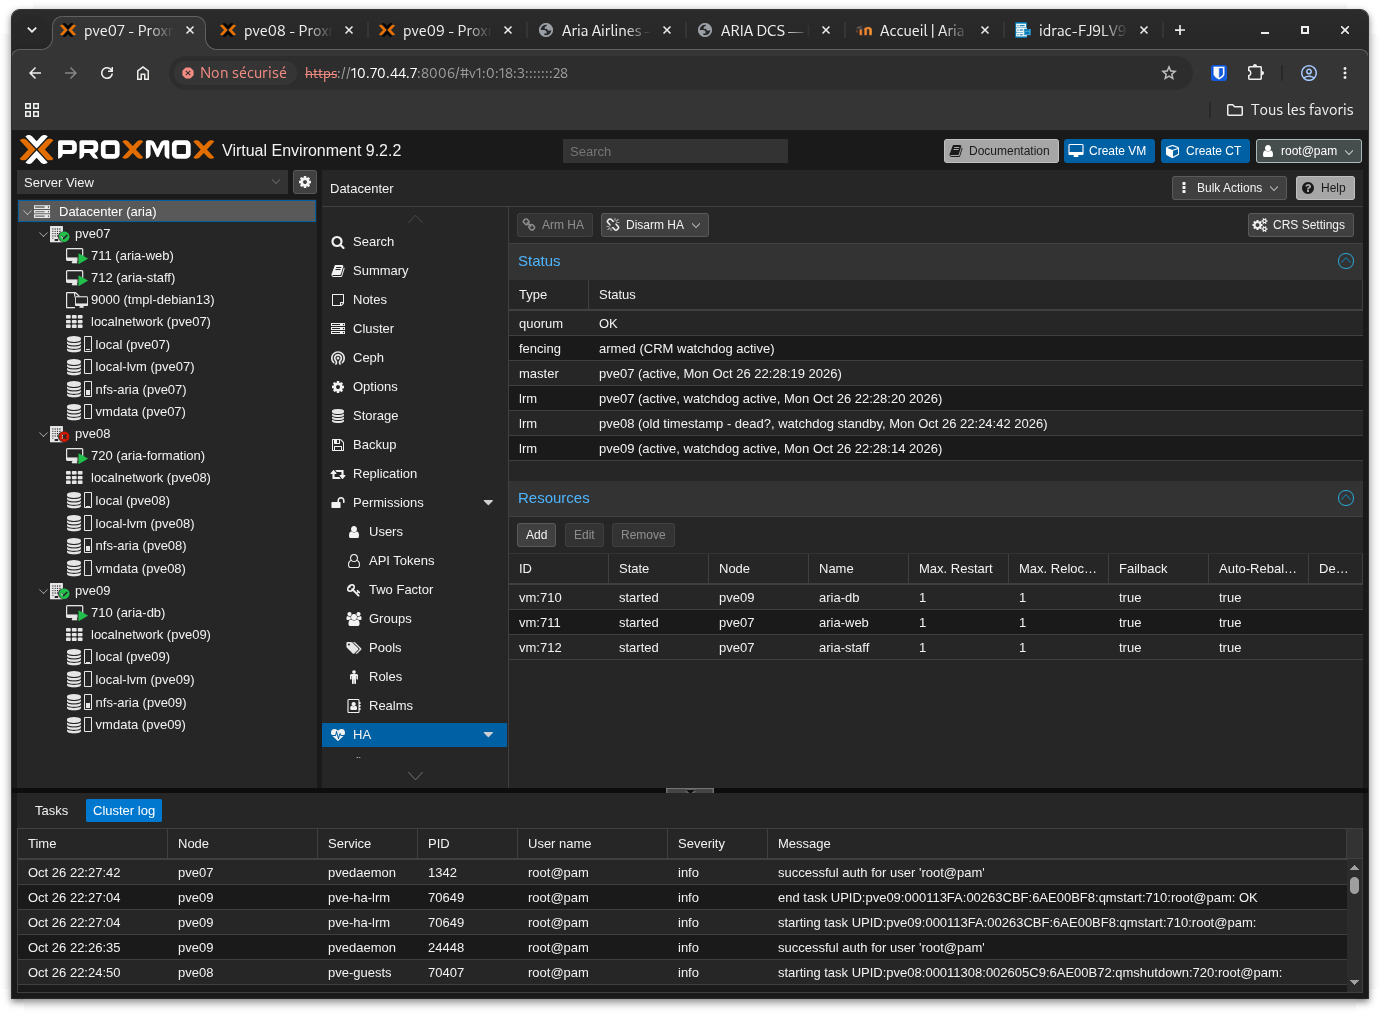
Au bout de trois à quatre minutes, les trois ressources passent à l'état started, réparties sur les serveurs 1 et 3. La HA a choisi elle-même où les placer.
Si le serveur 2 était aussi le master de la HA, ce qui est fréquent, la reprise prend une minute de plus : les serveurs 1 et 3 doivent d'abord élire un nouveau master, et c'est seulement lui qui déclare le fence. Les VM démarrent, Docker démarre avec elles, et l'option --restart unless-stopped relance chaque conteneur.
Étape 10 — Mesurer l'interruption
Revenez au Shell du serveur 1. Quand les lignes affichent de nouveau 200, arrêtez la boucle avec Ctrl+C.
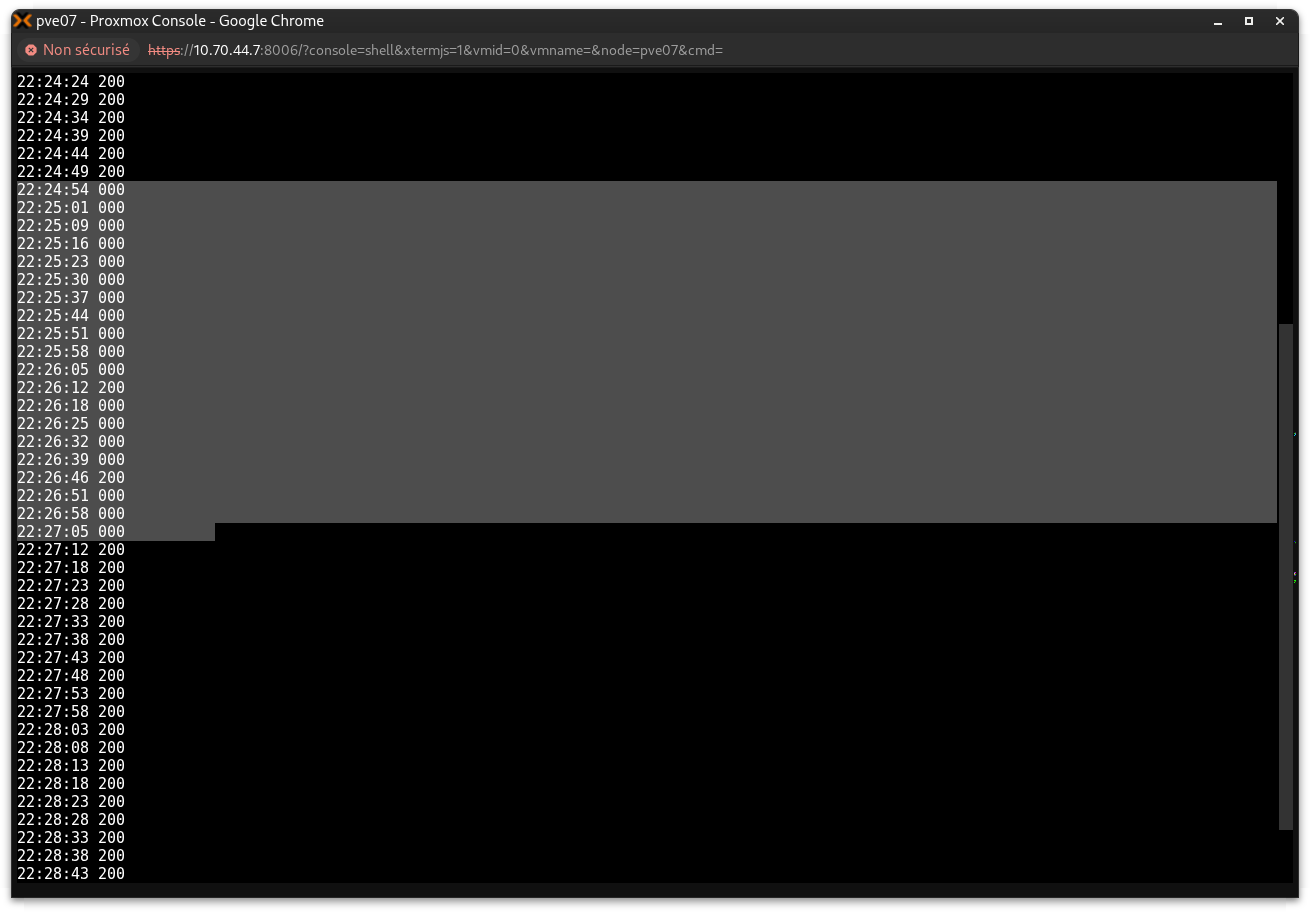
Repérez le premier 000 et le premier 200 qui le suit. L'écart entre les deux, c'est la durée de l'interruption du site de vente : environ trois à quatre minutes. Sans HA, il aurait fallu attendre qu'un technicien arrive, constate la panne et répare le serveur.
Étape 11 — Constater que les VM ont redémarré
Ouvrez la console de aria-db, sur son nouveau nœud, et connectez-vous.
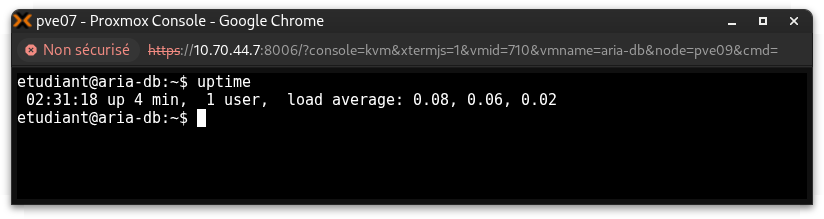
La VM tourne depuis une ou deux minutes. C'est la différence essentielle avec l'exercice 5 : la migration à chaud avait déplacé une VM vivante, la HA a redémarré une VM morte.
Étape 12 — Retrouver les données
Rechargez vos deux onglets. Au comptoir, choisissez le vol AR 118 d'aujourd'hui et ouvrez le dossier de LEFEBVRE/HUGO.
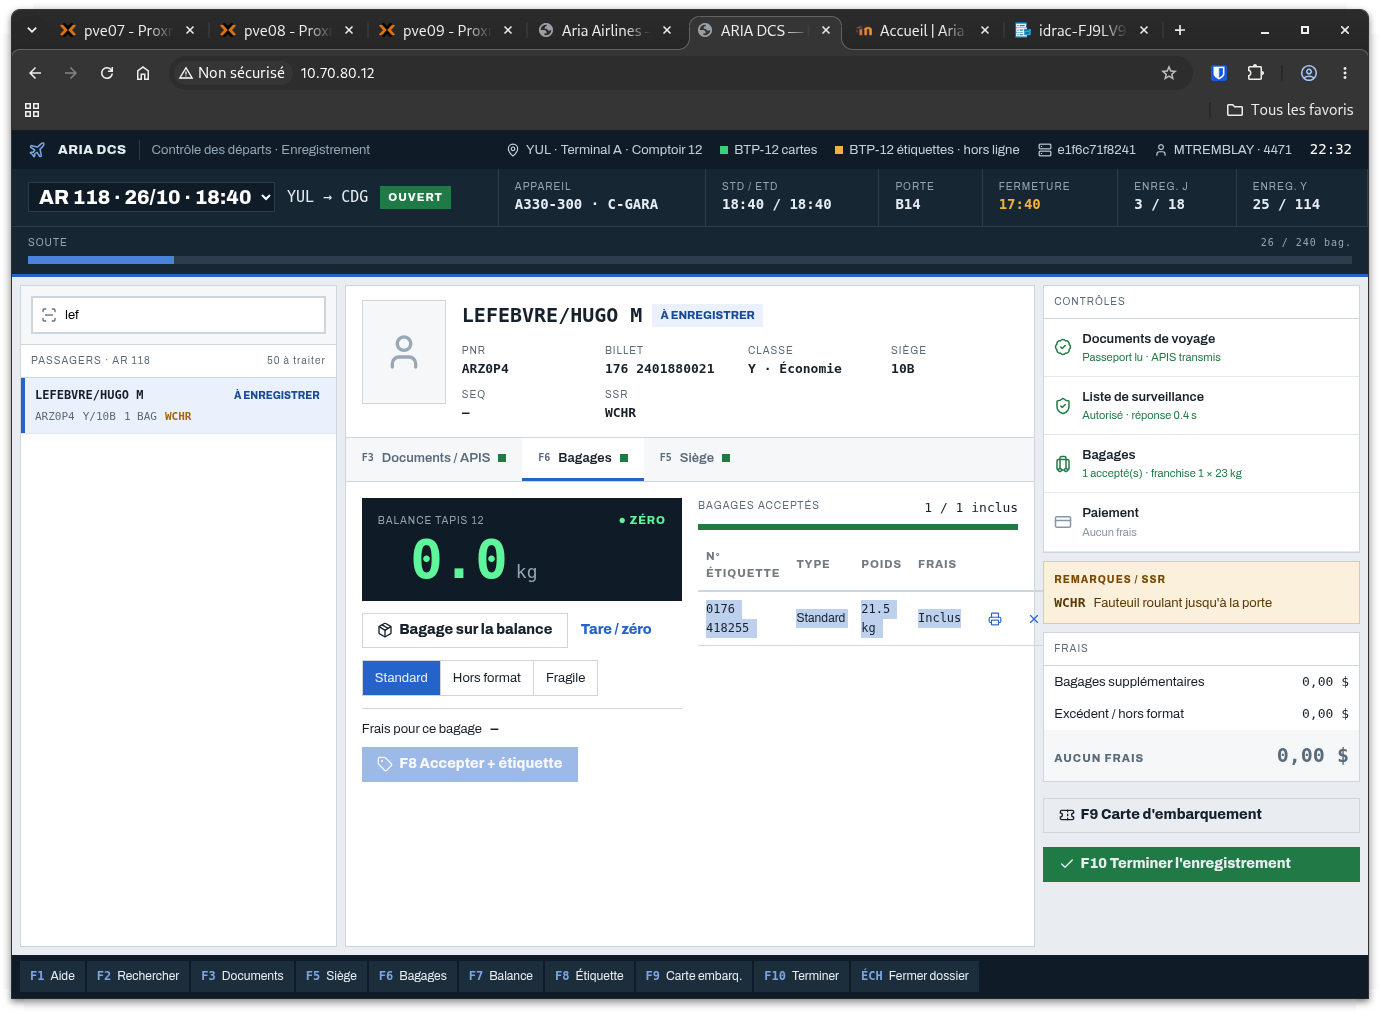
Le bagage accepté à l'exercice 5 est toujours là. Le disque de aria-db était sur nfs-aria : le serveur qui l'a redémarrée l'a retrouvé intact. Cherchez aussi le billet acheté à l'exercice 5 : il est là, lui aussi.
Étape 13 — Constater que la formation est arrêtée
Depuis votre poste, ouvrez http://10.70.8E.20.
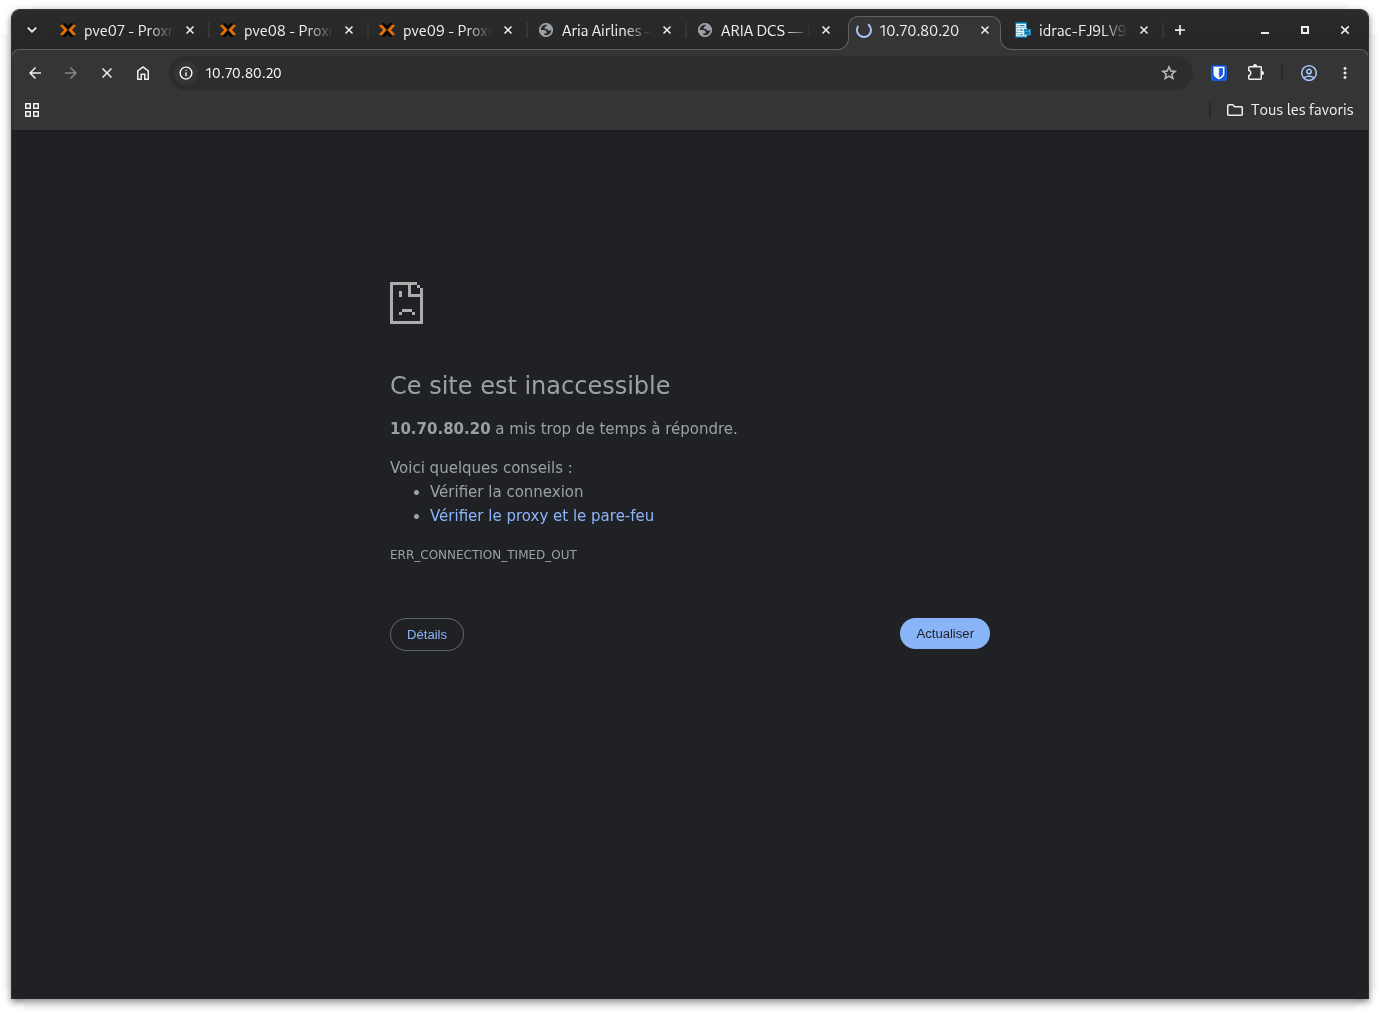
Aucune réponse. aria-formation est restée rattachée au serveur 2, grisée dans l'arborescence. Son disque est pourtant intact sur nfs-aria, exactement comme celui des trois autres. La seule différence, c'est qu'aucune ressource HA ne la désignait.
Étape 14 — Rallumer le serveur 2
Dans l'iDRAC du serveur 2, choisissez Power On System. Le serveur met jusqu'à une dizaine de minutes à démarrer et à rejoindre le cluster : le démarrage du matériel est long.
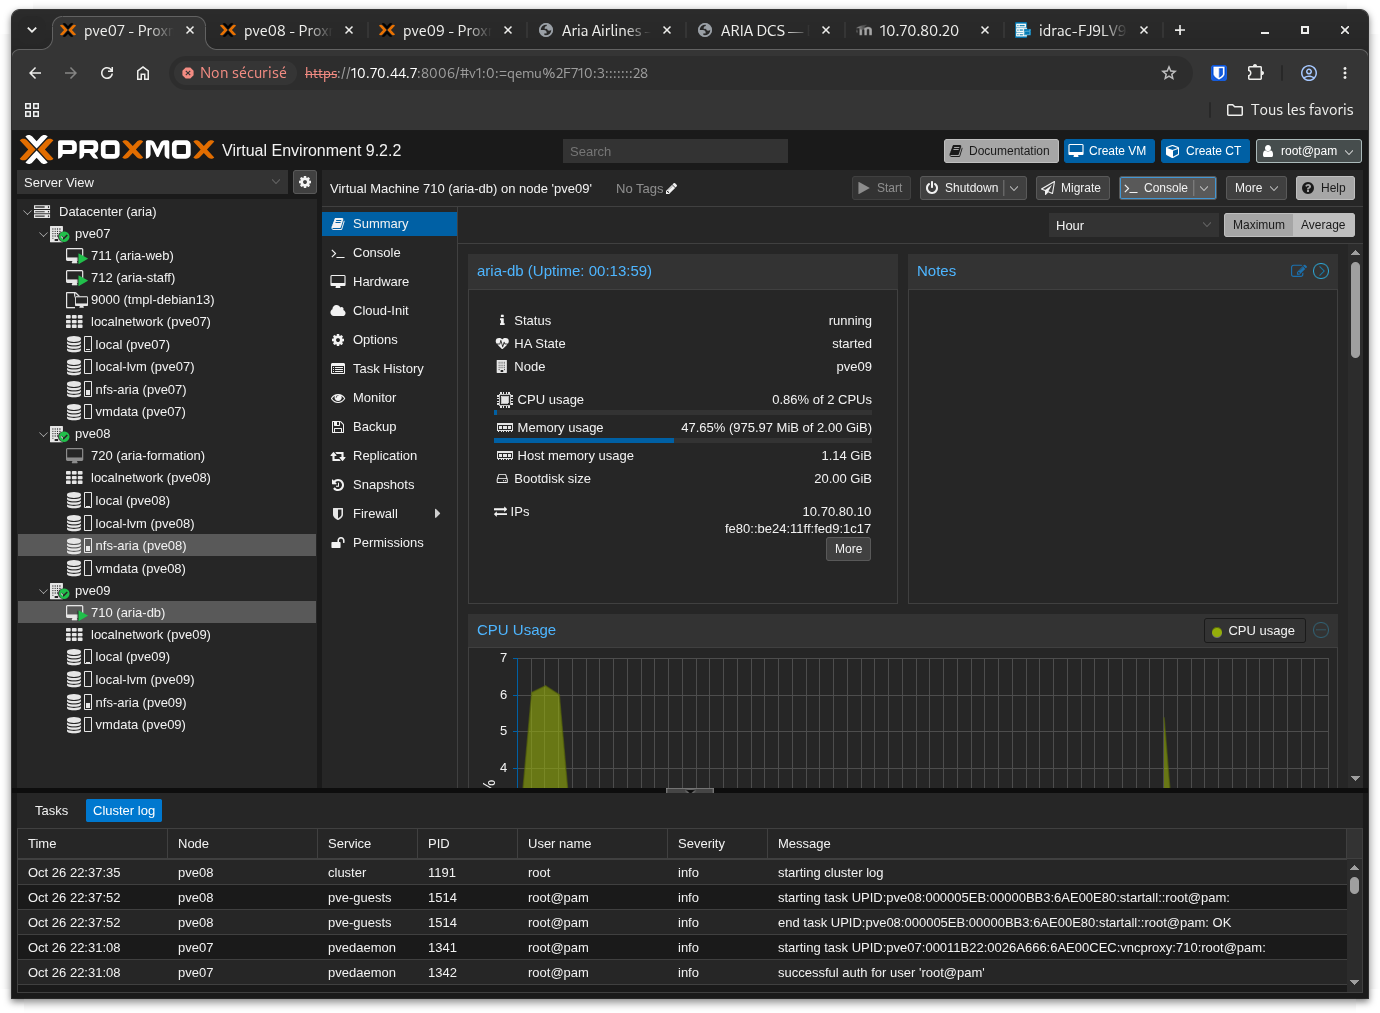
Le serveur 2 revient en vert. Les trois VM critiques restent sur les serveurs 1 et 3 : la HA ne les ramène pas d'elle-même. aria-formation, elle, est revenue avec son nœud, mais arrêtée.
Étape 15 — Redémarrer la formation à la main
Sélectionnez aria-formation et cliquez sur Start. Une minute plus tard, ouvrez http://10.70.8E.20.
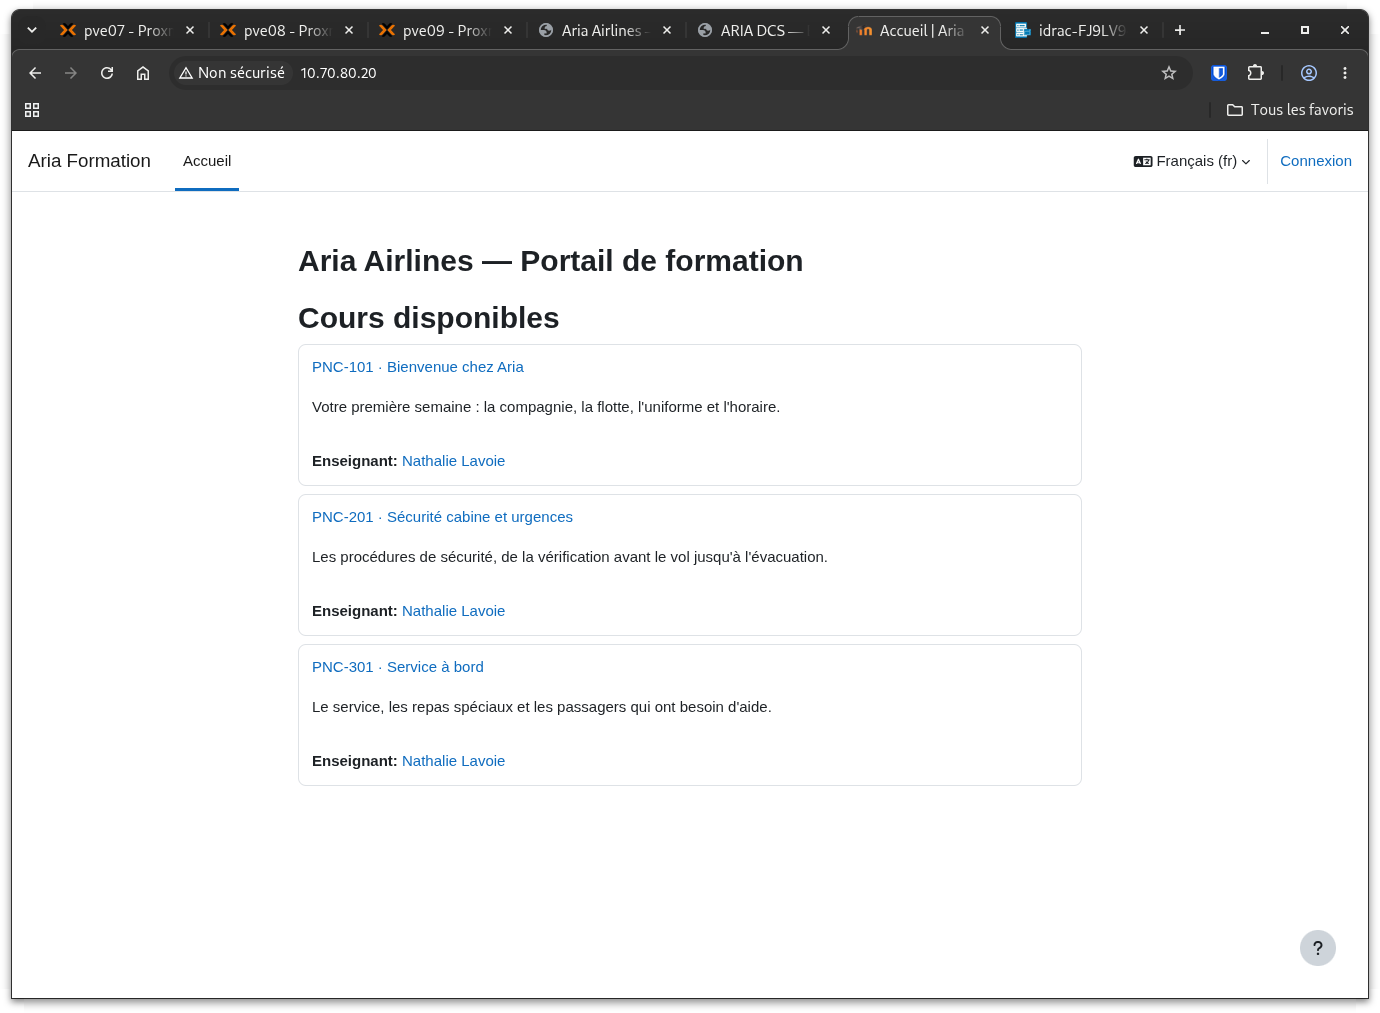
Le portail revient, sans réinstallation : ses tables et ses cours étaient dans aria-db, ses fichiers dans le volume Docker de son disque. C'est le geste qu'un technicien aurait fait le lendemain matin, et c'est exactement le niveau de service que la direction avait choisi pour lui.
Vérification finale
-
ha-manager statuslistevm:710,vm:711etvm:712, et pasvm:720 - Après la coupure du serveur 2, les trois ressources HA sont reparties d'elles-mêmes sur les serveurs 1 et 3
- La surveillance montre une interruption de quelques minutes, pas plus
- Le bagage et le billet de l'exercice 5 existent toujours
-
aria-formationest restée arrêtée jusqu'au Start manuel
Question 1
Le portail de formation tient sur le même stockage partagé que les autres VM. Pourquoi ne pas l'avoir ajouté à la HA, alors qu'il suffisait d'une ligne de plus ?
- a) Parce que Moodle ne supporte pas d'être redémarré sur un autre serveur.
- b) Parce que chaque ressource HA oblige chaque nœud à garder de la capacité en réserve pour l'accueillir, et que l'arrêt de ce service coûte moins cher que cette réserve.
- c) Parce que Proxmox limite la HA à trois ressources par cluster.
Voir la réponse
**b) Parce que l'arrêt de ce service coûte moins cher que la capacité réservée pour lui.** Si le serveur 2 tombe, les nœuds survivants doivent accueillir toutes les ressources HA qu'il portait. Chaque ressource ajoutée, c'est de la mémoire qui doit rester libre partout, jour et nuit, et qui ne sert à rien tant qu'aucun serveur ne tombe. La HA se réserve aux services dont une heure d'arrêt coûte plus cher que cette réserve. Le choix a) est faux : `aria-formation` a très bien redémarré à l'étape 15, et elle aurait redémarré de la même façon sur le serveur 1. Rien de technique n'empêchait de la protéger. C'est une décision d'affaires, pas une limite du logiciel.Question 2
Un coéquipier propose de protéger aria-web et aria-staff, mais pas aria-db, « parce que la base n'est pas visible des clients ». Que se passe-t-il si le serveur de aria-db tombe ?
- a) Rien de grave : le site et le comptoir continuent de fonctionner avec les données qu'ils ont déjà chargées.
- b) Le site et le comptoir restent en ligne, mais affichent « la base de données ne répond pas » jusqu'à ce que quelqu'un redémarre
aria-dbà la main. - c) La HA redémarre automatiquement
aria-db, parce quearia-weben dépend.
Voir la réponse
**b) Le site et le comptoir affichent que la base ne répond pas.** Les deux applications ne gardent rien en mémoire : chaque prix, chaque siège, chaque passager vient de la base au moment où la page le demande. Sans `aria-db`, elles tournent pour rien. Protéger un service sans protéger ce dont il dépend, c'est ne rien protéger. Le choix c) prête à la HA une connaissance qu'elle n'a pas. `ha-manager` ignore tout des liens entre vos applications : il ne voit que des VM, et il ne protège que celles qui lui ont été confiées.En cas de problème
| Symptôme | Cause probable | Correction |
|---|---|---|
Les ressources restent en fence plus de cinq minutes |
Les serveurs 1 et 3 n'ont pas le quorum | pvecm status sur le serveur 1 : il faut Quorate: Yes avec deux votes |
Une ressource passe en error |
La VM n'a pas pu démarrer sur le nouveau nœud | Lire le journal de la tâche ; souvent un snippet ou un ISO sur local |
La VM redémarre mais le site reste à 000 |
Le conteneur ne redémarre pas avec Docker | Console de la VM, sudo docker ps -a ; recréer le conteneur avec --restart unless-stopped |
| Le site affiche « la base de données ne répond pas » | aria-db démarre encore |
Attendre une minute ; le bandeau disparaît de lui-même |
aria-web refuse de s'arrêter, elle redémarre sans cesse |
C'est une ressource HA en état started |
Datacenter > HA > Resources, passer son état à stopped |